11 шагов до оффера Junior / Middle Java-разработчика
Представь большую комнату, забитую целой сотней людей.
Все хотят одно и то же место — тот самый оффер, ради которого ты читаешь этот текст.
В итоге выйдет один человек.
Не “кто-то из многих”, а конкретный человек, который оказался сильнее остальных и по знаниям, и по резюме, и по тому, как он умеет разговаривать.
Тебе нужно обойти не "почти всех из 100", а ВСЕХ из 100
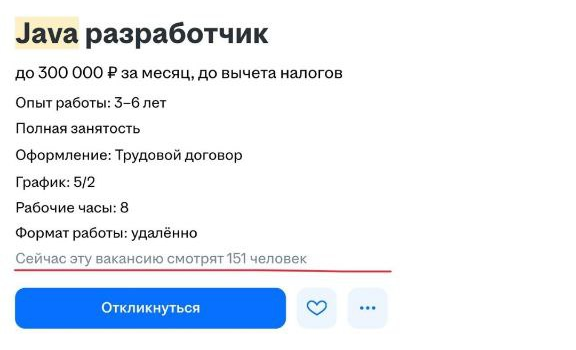
Этот гайд не будет не про “поверь в себя, и всё получится” и прочий булщит. Он про то, что именно нужно сделать, чтобы стать этим человеком.
Сейчас честно: если бы собес был завтра, ты бы оказался ближе к верхним 5 людям в этой комнате или в хвосте, который даже до технического собеса не дойдёт?
Тут не будет волшебных таблеток и “секретов от HR”.
Будет неприятная и честная правда: где ты сейчас недооцениваешь сложность пути, где переоцениваешь свои знания, где вообще смотришь не туда.
Я сам был тем человеком, который долго откладывал важные решения, не понимал куда и как идти, как себя вести на собеседованиях.
Что нужно знать, а что пропустить.
Однажды я слишком рано обрадовался офферу и перестал ходить на собесы.
В итоге потерял деньги и время.
После этого гайда я хочу, чтобы ты эти ошибки просто не допустил.
Моя задача — показать тебе карту.
Одиннадцать шагов от точки “я хочу войти в IT” до момента, когда ты получаешь оффер и нормально проходишь испытательный срок на junior или middle позицию, а не вылетаешь через месяц.
Почему стоит целиться именно в junior-middle?
Формально ты, может быть, целишься в джуна. Но в текущих реалиях рынок устроен так, что джунов как класса почти не существует.
Почему так:
- Вакансий на джунов сильно меньше, чем на мидлов. Мы с тобой не можем “в 10 раз увеличить количество джунских позиций”. Это данность.
- Бизнесу нужны мидлы, а не новички. Компаниям нужны люди, которые придут, быстро вольются в команду и начнут решать реальные бизнес-задачи: писать бэкенд, разруливать проблемы, брать ответственность. Особенно в кризис никому не хочется тянуть за руку человека, который полгода только входит в курс дела.
- Требования к джунам и мидлам почти сравнялись. Из-за большой конкуренции планка для джуна по факту очень близка к тому, что раньше спрашивали с мидла. Где-то на джуна могут спросить вопросы уровня сильного мидла или просто старых “сеньорских” собесов пятилетней давности.
Я для прикола шёл собеситься “на джуна”, когда уже был сеньором. Отвечал на все вопросы идеально, прям без запинок. И мне прилетел оффер… на 100к. Ссылка на видос с этого собеса на YouTube
Отсюда логика простая:
- целиться нужно не “в вкатуна джуна”, а в уровень junior-middle — чтобы тебя вообще имело смысл рассматривать
- готовиться нужно так, как будто ты идёшь конкурировать не с такими же новичками, а с людьми, которые тоже годами учились и работали
Поэтому если ты начинающий разработчик, то просто смирись с тем, что будет тяжело.
Собеседуйся и на джунов и на мидлов
Единственная по-настоящему работающая гарантия, которую я могу тебе дать:
Ты не проиграешь, если не сдашься. Если ты не сдашься и будешь продолжать учиться, практиковаться и ходить на собесы — у тебя есть шанс. Сдашься - шансов не останется.
Как пользоваться этим гайдом
Сначала прочитай всё целиком, без попытки сразу что-то переписывать и планировать.
Тебе нужно увидеть весь маршрут, а не зациклиться на одном шаге.
Потом честно ответь себе на вопрос: “На каком шаге я застрял?”.
Очень часто проблема не в том, что “я мало знаю технологию Х”, а в том, что
- резюме не проходит фильтры и тебя вообще не зовут на собесы
- ты технически понимаешь темы, но слишком поверхностно и не умеешь объяснять решения
- ты знаешь непозволительно мало или мало уделяешь времени и фокуса учебе
- ты год учишься, но почти не ходишь на реальные интервью и не получаешь фидбек
Одна из главных задач вообще в карьере — распознать свой текущий ограничитель. Где именно у тебя рвётся цепочка: на знаниях? на резюме? на собесах? на финалках? на софтах?
Пока читаешь, отмечай главы, на которых у тебя внутри щёлкает “бля, вот это про меня”. Именно там, скорее всего, твой текущий блокер. В конце вернёшься к этим пометкам и составишь себе план.
Далее направляй весь фокус туда, где ты сейчас реально буксуешь, а не туда, где ты привык обычно качаться.
Принимай решения, ДЕЛАЙ И ДУМАЙ сам, осознанно. Это твоя жизнь. Если твоя свобода и жизнь зависит всего лишь от того, что тебе нужно поработать усердно год, то это стоит того.
Четыре этапа пути
Весь путь до оффера можно честно разложить на четыре больших этапа:
- Фундамент и план — ты перестаёшь метаться и понимаешь, чем именно будешь заниматься ближайшие месяцы
- Базовые навыки — Java Core, SQL, основы разработки, первые проекты
- Продвинутый стек — Spring, базы, Kafka/Redis, микросервисы. Тут появляется уровень ближе к мидлу
- Выход на рынок — резюме, отклики, собесы, оффер, испыталка
Теперь давай пройдёмся по каждому шагу.
Шаг 1. Составь честный план обучения
На этом шаге тебе нужно сделать неприятную, но нужную вещь: снять розовые очки и посмотреть правде в глаза.
Сколько часов в неделю ты реально можешь учиться?
Не в фантазии “я буду ебашить по 6 часов каждый день”, а в своём реальном графике: работа, учёба, семья, усталость.
Самая частая ошибка - люди “начинают учить Java”, не понимая вообще ничего про свой режим и загрузку. Покупают курс, смотрят пару занятий, исчезают, потом возвращаются с чувством вины. Так можно годами “что-то учить” и никуда не сдвинуться.
От этого времени и твоего текущего уровня рождается примерная длина пути. Может быть 3–4 месяца, может быть 9–12. Это нормально.
Важно не то, как быстро добежишь, а будешь ли ты вообще продолжать бежать, когда станет тяжело.
Люди с очень разной стартовой точкой приходят похожим к офферам. Нет каких-то "супер-уникальных" условий.
Ты не особенный, всем тяжело.
Очень многие на этом этапе делают две ошибки:
- не закрепляют ничего на практике: посмотрели лекцию — и пошли дальше. НЕ делайте так!
- рано опускают руки: “месяц занимаюсь, прогресса не видно, всё, не моё”
Гораздо важнее просто не останавливаться, чем пытаться идти идеально. Человек, который далеко дошел, а потом сдался перед финишем, проигрывает тому, кто только начинает, но не собирается останавливаться.
Дальше ты честно оцениваешь примерный объем стоящих перед тобой задач:
- по месяцам: что ты изучаешь - Java Core → SQL → первый проект → Spring → микросервисы → выход на рынок
- с примерными дедлайнами - “до середины февраля закрываю базовый SQL и Spring Boot. до марта разбираюсь в микросервисах”
- с примерным прогнозом по времени: “если делаю 10–15 часов в неделю — у меня уйдёт около N месяцев”.
Очень важный момент! Этот план должен меняться во времени. Вы постоянно должны его сверять с реальностью и корректировать. Хотя бы каждый месяц сверять что вы действительно сделали и корректировать сроки.
Пока у тебя нет такого плана, всё остальное — просто хаотичное бродилово туда-сюда.
Шаг 2. Java Core: начать понимать основы
Core встречается везде от собеседований до фактически самой работы.
На собесах по Java тебя могут копать вглубь. Если ты знаешь темы поверхностно, то это сыграет тебе в минус
Твой ориентир по Java Core:
- база, которая даже не обсуждается: циклы, условия, ветвления, типы данных, переменные, объекты, примитивы.
- ты нормально понимаешь основы ООП: инкапсуляция, наследование, полиморфизм, абстракция, можешь объяснить это своими словами и привести простой пример кода;
- ты не боишься коллекций: понимаешь разницу между ArrayList и LinkedList, зачем нужен HashMap, когда выбрать HashSet, а когда TreeMap;
- ты умеешь пользоваться Stream API, понимаешь, когда он делает код проще, какие есть виды операторров
- у тебя есть представление об основах многопоточности: что такое Thread, зачем нужна синхронизация, что такое race condition, почему “~~похуй~~ и так сойдёт без synchronized” в многопоточке не работает
- ты уверенно работаешь с исключениями: try-catch-finally, try-with-resources, умеешь объяснить, зачем это всё, и написать рабочий пример.
Хороший маркер по любой теме: если ты можешь объяснить её другу примерно твоего уровня (или чуть ниже) и из головы придумать пример кода, где это применимо = ты плюс-минус понял.
Объяснять прямо как в книжке НЕ нужно.
Объясняй так, чтобы живой человек понял зачем это вообще нужно. Этот навык пригодится тебе в работе и на собесах.
Если на этом шаге решишь наебать сам себя, то дальше всё будет плохо.
Spring, Kafka, микросервисы — это всё построено на том, что ты умеешь нормально писать код на Java, а не копировать с ChatGPT.
Шаг 3. SQL: погрузиться в базы данных
SQL многие считают “чем-то второстепенным”. Типа “потом добью, сначала бы Java выучить”.
В реальности в продакшене тебе почти всегда придется работать с SQL БД. И на собесах тебя всегда хоть что-то да спросят про БД, а иногда и почти весь собес может быть про работу с БД.
Твой базовый уровень должен включать:
- понимание, что такое таблица, как их создавать и как с ними работать.
- зачем нужны нормальные формы на уровне “почему нельзя всё хранить в одной огромной таблице”, хотя бы 3 первые нормальные формы понимать
- умение писать простые запросы: SELECT, INSERT, фильтрация через WHERE, сортировка, базовые JOIN’ы
- понимание, что такое PRIMARY KEY, FOREIGN KEY, какие бывают ограничения (NOT NULL, UNIQUE и т.п.) и зачем они нужны
- умение делать группировки через GROUP BY и фильтрацию агрегатов через HAVING
- базовое представление о транзакциях и гарантиях ACID: зачем они нужны, что такое атомарность, уровни изоляции
Очень типичная картина на собесе:
- “Я знаю SQL”.
- “Окей, напиши запрос: вернуть количество заказов по каждому пользователю за последний месяц, только по тем, у кого больше трёх заказов”.
- "А ну, эм, пу-пу-пу"
Тебе это не нужно.
Если тебе на собесе дают схему и просят написать запрос, или спрашивают: “А что будет, если…”, ты должен уметь рассуждать, и хотя бы мочь написать простой sql в реальном времени.
Шаг 4. Основы разработки приложений: тесты, инструменты, паттерны
Между “я знаю синтаксис Java и чуть-чуть SQL” и “я готов идти в Spring и микросервисы” есть важный мост.
Это основы разработки приложений. На этом шаге ты:
- знакомишься с тестированием: юнит-тесты на JUnit, базовая работа с Mockito, понимание, чем вообще отличаются юнит и интеграционные тесты
- разбираешь принципы SOLID и написание масштабируемого кода
- осваиваешь один инструмент сборки — Maven или Gradle, понимаешь, как подключаются зависимости, как собирается проект
- переходишь от “я просто пишу файлы” к работе с Git: коммиты, ветки, merge, pull requests
- понимаешь в общих чертах, чем backend отличается от frontend’а, как выглядит типичный процесс разработки в команде, кто чем занимается
- знакомишься с базовыми паттернами проектирования: фасад, стратегия, адаптер
Эти знания потом очень пригодятся, когда ты полезешь в Spring Boot и микросервисы - у тебя уже будет контекст
Шаг 5. Spring Boot и HTTP: начинаем изучать фреймворки
В какой-то момент надо выйти в реальность: в проде ты почти всегда будешь писать не на голой Java. Самый популярный и часто-используемый фреймворк для разработки на Java это Spring Boot.
На этом шаге ты разбираешься:
- что такое Spring Core, Inversion of Control и Dependency Injection. Не на уровне “ну типа спринг там сам разрулит”, а понимать как Spring управляет бинaми и их зависимостями
- что такое HTTP, как устроен протокол с методами, статус-кодами, заголовками
- как вокруг этого Spring Boot строит REST-сервисы: контроллеры, маршруты, обработка запросов, ответы в JSON
- как выглядит нормальный REST-endpoint, через который другая система может общаться с нашим сервисом
В идеале у тебя к концу шага должен быть маленький, но живой REST-сервис на Spring Boot, в который можно отправлять HTTP запросы: создать несколько разных сущностей, получить, обновить, удалить, вернуть осмысленную ошибку, а не просто 500.
Шаг 6. Spring + SQL: связать код и данные
Дальше тебе нужно перестать хранить все в памяти. Пора подружить твой код с реальной базой данных.
Здесь в игру вступают JPA, Hibernate, Spring Data: сущности, репозитории, связи между таблицами. На этом шаге ты учишься:
- описывать модель данных через @Entity и связи OneToMany/ManyToOne/ManyToMany
- понимаешь, что такое ленивые и жадные загрузки, проблема N+1 и как ее решить
- используешь Spring Data, чтобы не писать вручную SQL там, где можно обойтись репозиториями
- знаешь что такое миграции Flyway/Liquibase, чтобы база жила в том же ритме, что и код
- уметь писать кастомные запросы к БД, фильтрацию, постраничную выборку из БД
Тут важно не просто “запустилось — и ладно”, а понимать, что примерно происходит под капотом: ORM генерирует SQL, идёт запрос в базу, данные превращаются в объекты и обратно.
К этому моменту ты должен уметь писать сервисы, которые не только отдают заглушки, а реально читают и пишут данные в БД.
Шаг 7. Kafka и Redis: выйти за рамки “типичного джуна”
До этого момента твоя картина мира была примерно такая: есть сервис → он получает HTTP-запрос → что-то делает → пишет в базу → отвечает.
Это работает, пока нагрузка небольшая, бизнес-процесс простой, никого особо не волнуют задержки и редкие фейлы.
Дальше начинается зона, которая выводит тебя за пределы типичного минимального джуна, который умеет только CRUD по HTTP
Во-первых, ты знакомишься с Kafka: что такое брокер сообщений, топики, партиции, продюсеры, консьюмеры, консьюмер группы.
Зачем вообще нужна асинхронная обработка, когда HTTP уже не хватает.
Во-вторых, ты знакомишься с Redis как быстрым in-memory хранилищем и кэшем: где он реально экономит ресурсы, какие структуры данных там есть, как его подружить со Spring.
Redis хранит данны в оперативке и позволяет
- читать/писать их очень быстро;
- не грузить лишний раз основную SQL БД
Важно не просто знать что Kafka и Redis существуют, а понимать когда использовать HTTP, когда Kafka, а когда кэш.
Типичный вопрос на собеседовании:
“У нас есть сервис заказов, который при каждом оформлении заказа дергает еще три сервиса: склад, платежи и уведомления. Всё стало тормозить. Что вы будете делать?”
И вот здесь ты уже не отвечаешь “ну… наверное, оптимизирую код”, а предлагаешь нормальное решение.
У меня был почти такой же реальный кейс:
монолитный сервис заказов, который при каждом заказе синхронно дёргал оплату, склад и уведомления. Пока заказов было 50 в день всё ок. Когда стало 500+, то пользователи начали смотреть на крутящийся спиннер по 15–20 секунд.
Решение с командой придумали такое, а я его реализовал:
— вынесли часть логики в асинхронную обработку через очередь
— пробиваем оплату и показываем пользователю “заказ принят”, а всё остальное докручиваем в фоне
— самые горячие данные закэшировали в Redis.
На собесе от тебя ждут хотя бы такого уровня рассуждений, а не “ну я бы оптимизировал базу/код”
Так ты будешь реально кандидатом уровня junior-middle, а не просто “вкатун джун с chat gpt”.
Шаг 8. Системный дизайн и микросервисы: видеть картину шире одного сервиса
Этот шаг — про то, чтобы перестать мыслить “одним приложением” и начать думать о системе в целом.
Монолит vs микросервисы — это база
- Монолит - один сервис, одна база, один деплой. Очень просто стартовать, быстро пилить фичи в начале. Вылезают проблемы, когда система растет и нужно масштабироваться.
- Микросервисы - разбиваем систему на несколько сервисов по доменам: пользователи, заказы, платежи и т.д.
- Получаем плюшки: независимые деплои, проще масштабировать горячие места, командам легче разделиться.
- Получаем хуюшки: проблемы с сетью, консистентностью, отказами, сложнее дебажить, сложнее держать всё в голове.
Как вообще масштабируется система
На уровне системного дизайна ты должен понимать базовый путь эволюции:
- Один сервис + одна база. Всё просто, дешево, удобно. Подходит для начала и малого объёма.
- Горизонтальное масштабирование сервиса. Несколько инстансов за балансировщиком: нагрузку разбросали по копиям, но база пока одна.
- Масштабирование базы. Репликации master-slave, шардирование. Здесь уже появляются истории про консистентность, задержки репликации и т.п.
- Разделение на несколько сервисов. Отделяем, например, биллинг, пользователей, заказы в отдельные сервисы, каждый со своей базой и своим жизненным циклом.
На каждом этапе ты что-то выигрываешь скорость, надёжность, гибкость, но теряешь простоту, предсказуемость, консистентность.
На собеседованиях часто важно не угадать рандомно ответ, а показать ход мысли: ты умеешь формулировать проблему, предлагать решение, оценивать его плюсы/минусы и сравнивать с альтернативами.
Здесь как раз очень полезен один шаблон ответа, который годится почти для любого инженерного вопроса, который я сам использую.
- Сначала объясни, какую проблему решает эта штука - зачем она вообще нужна
- Потом расскажи, как выглядит решение: что именно предлагается, как оно работает
- Разбери плюсы: что хорошего даёт это решение
- Назови минусы и trade-off’ы
- Скажи, как можно смягчить минусы
- И покажи альтернативы: какие есть ещё варианты и почему ты выбрал именно этот
Если ты так отвечаешь, даже на сложные темы ты выглядишь как человек, который думает, а не как ̶д̶о̶л̶б̶а̶е̶б̶ вкатун вооружившийся чатом гпт.
На собеседованиях на этом уровне от тебя уже хотят не просто “список терминов”, а умение думать: “Вот такая задача. Как бы ты её построил? Какие варианты? Какие у них плюсы и минусы?”
Шаг 9. Резюме и отклики: кровавые фильтры
В текущих реалиях самая большая проблема даже не в твоих хард скиллах, а в том, чтобы тебя вообще допустили до собеса.
Порядок примерно такой:
- Твоё резюме сначала смотрит нейросетка / ATS-система (система отслеживания кандидатов) Она проверяет ключевые слова, структуру, понятность описания опыта
- Потом фильтры и HR.
- И только если ты прошёл эти уровни, тебя увидит технический специалист.
Если у тебя нет опыта в резюме, мало технологий или всё написано абстрактно - HR тебя даже не увидит. Не потому, что ты плохой специалист. Просто тебя отфильтровал ИИ.
Что это значит для тебя
Во-первых, резюме — это не “какая-то бумажка, на которую пофиг, главное, что я специалист”.
Это такой же важный этап, как изучение Java или микросервисов. Если ты его не проходишь, то ты проиграл.
Во-вторых, нужно понимать, как тебя вообще ищут. Если в твоём резюме нет ключевых слов вроде:
Java, Spring Boot, PostgreSQL, REST, HTTP, Docker, Kafka, Redis, Kubernetes и тд,
и они не привязаны к конкретным достижениям и задачам, то в поисковой выдаче ты будешь где-то внизу, и тебя просто не откроют.
Про “накрутку” и честность
Реалия такая: даже если ты уже опытный разработчик с 2–3 годами реальной работы, рынок всё равно заставляет тебя переупаковывать свой опыт так, чтобы он:
- был хорошо читаем для нейросетей и ATS;
- выглядел как понятный, структурированный опыт в релевантном стеке;
- показывал конкретные задачи и результаты, а не “делал задачи, чинил баги”.
Если же ты заходишь без коммерческого опыта, ситуация ещё жёстче.
Если просто честно написать “я ничего не делал, но очень хочу работать”, то в 99.9% случаев твое резюме не дойдет даже до человека.
Единственно рабочее решение на текущем рынке - это накрутка опыта резюме и его упаковка
- В резюме пишем будто вы реально где-то работали на нормальном стеке, писали нормальную бизнес-логику, работали в команде.
- За основу берем опыт в других сферах или пет-проекты. Но опыт должен быть практически неотличим от настоящего. И вы должны уметь пояснить за него.
- Не писать откровенного пиздежа в духе “Senior Java Developer в Google”, когда ты три месяца писал todo-list левым глазом. Вас могут спалить на любой фигне, которую вы необдуманно сказали/написали.
САМОЕ ГЛАВНОЕ - накрутка не решает фундаментальной проблемы в храдах. Вам надо быть реально крутым специалистом и понимать как работают технологии, как их использовать, уметь аргументировать решения и т.д.
Если ты прям капец как боишься, что на собесе всплывёт накрутка и тебя разоблачат и до конца жизни будут показывать на тебя пальцем, и все твои близкие от тебя откажутся - скажи про накрутку сам, но только уже на тех. собесе.
“Смотрите, я честно: у меня нет формального коммерческого опыта, я его компенсировал учебными и боевыми pet-проектами. В резюме я максимально упаковал их так, как если бы это были реальные задачи в компании, потому что иначе HR и ATS меня просто не пропустит. Но всё, что там написано по стеку и задачам — я реально делал: вот GitHub, вот код, могу рассказать, как оно устроено и зачем….”
В такой конфигурации большинство тебе скажут: “Окей, мне вообще не важно, что написано в колонке “формальный опыт”, мне важно, что ты умеешь и как думаешь”.
Я не рекомендую так делать, это может снизить ваши шансы, но в крайнем случае это можно использовать. Других нормально повторяемых способов все равно нет.
ИТОГ - почему нельзя игнорировать этап с резюме и его правильным составлением
- если ты забиваешь на резюме и отклики, то тебя даже не увидят
- если ты упаковываешься грамотно, с ключевыми словами, конкретикой, нормальными описаниями задач и результатов - ты хотя бы получаешь шанс дойти до собеса и показать себя на нем
И это не “нечестный хак”, а часть игры в текущем рынке.
Каждый из этих этапов важен. Провалишь любой - ты просто не пройдешь дальше.
Шаг 10. Первые 5–10 собесов и цикл обратной связи
Готовиться к собеседованиям нужно заранее и постоянно!!
Параллельно с тем, пока ты учишься и пишешь резюме. Не в формате “через три дня собес, пойду погуглю вопросы”, а постоянно!
- ты находишь подборки реальных вопросов по Java, Spring, SQL, системному дизайну
- не просто смотришь, а реально разбираешь каждый: понимаешь ли ты, как это работает внутри
- если чувствуешь, что забоксовал — копаешь глубже: читаешь, пишешь код, рисуешь схемы, объясняешь вслух
Реально объём не такой огромный.
Да, это может быть 200–300 вопросов/тем, но если от этого зависит твоя зарплата, свобода, будущее твоё и семьи. Это пиздец как странно жалеть время на их нормальную проработку.
Дальше тебе нужно ходить на собесы, а не бесконечно “готовиться к ним”.
Тут многие ломаются. Одни идут на собесы слишком рано, получают пару отказов и решают, что “айти не для меня”.
Другие годами готовятся и боятся вообще нажать кнопку “откликнуться”.
Правильный путь — это цикл: подготовка → собес → разбор → корректировка → следующий собес.
После каждого собеса желательно:
- выписать вопросы, которые задавали;
- отметить, где ты плыл, где отвечал неуверенно;
- вернуть эти темы в свой план и добить.
На собеседованиях оценивают НЕ ТОЛЬКО твои харды!
- как ты объясняешь
- как реагируешь на критику
- признаёшь ли, что чего-то не знаешь, и как тогда рассуждаешь
- умеешь ли вообще нормально разговаривать
Если у тебя уже нормальный технический уровень, но ты проваливаешься на финалках, то твой текущий блокер скорее всего софт-скиллы и самопрезентация.
И в таком случае логично на время забить на прокачку хардов и месяц-два долбить именно софты: учиться рассказывать, убеждать, быть понятным, тренировать самопрезентацию и поведенческие ответы.
Шаг 11. Оффер, торг и испытательный срок
Тут легко выстрелить себе в ногу от радости. Прямо как это сделал я. Не будьте как я.
Несколько лет назад. Я миддл разработчик. Сходил на два собеса, внезапно получил оффер на сумму в 200к, которая казалось тогда очень большой, и мозг такой: “Бери! Срочно! Всё, жизнь удалась”. Я конечно же принял сразу.
Не будьте таким как я - торгуйтесь. Почти всегда можно выбить оффер к офферу +10-20к руб.
Следующая ошибка — останавливаться.
Даже если оффер уже в руках, пока ты официально не вышел и не прошёл испыталку: оффер могут отозвать, условия могут поменяться, команда может тебе не понравиться в первые дни.
Задача на этом шаге:
- не прекращать ходить на собесы сразу после первого оффера — добери ещё 2–3, хотя бы для опыта и сравнения
- не бояться торговаться: в большинстве компаний в оффер закладывают пространство для обсуждения
- смотреть не только на деньги, но и на стек, процессы, команду. Особенно если речь идёт о долгосрочной работе.
Отдельная тема — испытательный срок. Тут важно не “зажаться и молчать”, а показывать себя как человека, который решает проблемы: спрашивать, что главное, брать задачи, доводить до конца, не сливаться при первых трудностях.
Сколько это занимает по времени
Честные сроки в которые действительно можно добиться результатов. Многие курсы или менторы будут предлагать вам быстрые сроки.
Реальность такова, что часто сроки указывают либо супер оптимистичные, либо вообще нереалистичные.
Я дам вам сроки, которые я считаю хорошими ориентирами с учетом того, что вы не бросаете и не делаете больших перерывов.
- если ты стартуешь с нуля и можешь уделять 5–10 часов в неделю, то путь может занять 9–15 месяцев
- если уже есть база Java Core, SQL, может быть немного Spring и ты делаешь 10–15 часов в неделю — 3-6 месяцев учеба и 1-4 месяца поиск работы параллельно с учебой
- если у тебя высокий темп 15–20+ часов в неделю и ты не ноешь, когда тяжело - 3–6 месяцев до первых офферов реально, если есть база Java Core, SQL, Spring Boot
Это не гарантия. Это вилка, основанная на текущих реалиях рынка, что бы пройти все одиннадцать шагов.
Что делать после прочтения
Сейчас у тебя на руках не “идеальный план на жизнь”, а рабочая карта. Следующий шаг очень простой:
- Определи, на каком из 11 шагов ты застрял прямо сейчас.
- Выкинь иллюзию, что проблема всегда в нехватке хардов. Возможно, твой реальный блокер это резюме, отсутствие практики собесов или софты.
- Делай фокус именно туда, где у тебя сейчас узкое горлышко. Не распыляйся.
Путь до оффера не будет лёгким. Но он абсолютно проходимый. Люди с меньшими стартовыми данными, чем у тебя, уже прошли его.
Вопрос только в том, будешь ли ты дальше “немного учить Java” или честно зайдёшь в этот путь как проект: с планом, дедлайнами и одиннадцатью шагами, которые ты закроешь по очереди.
Мое последнее напутствие
Вернись мысленно в ту самую комнату со ста людьми.
Карта у тебя теперь есть.
Дальше вопрос не ко мне и не к рынку, а только к тебе:
готов ли ты перестать просто “интересоваться IT” и начать относиться к этому как к проекту, который ты добиваешь до конца.
See also